



robots.txt, arama motoru botlarına sitenizin hangi bölümlerini taramasını istediğinizi söyleyen düz metin dosyasıdır. Bir tarama kontrolüdür, dizin kontrolü değildir: engellenen bir adres, başka sitelerden link alıyorsa yine de adres olarak dizinde görünebilir. Sayfayı aramadan çıkarmak için noindex gerekir, farkı robots.txt ve noindex rehberinde bulabilirsiniz.
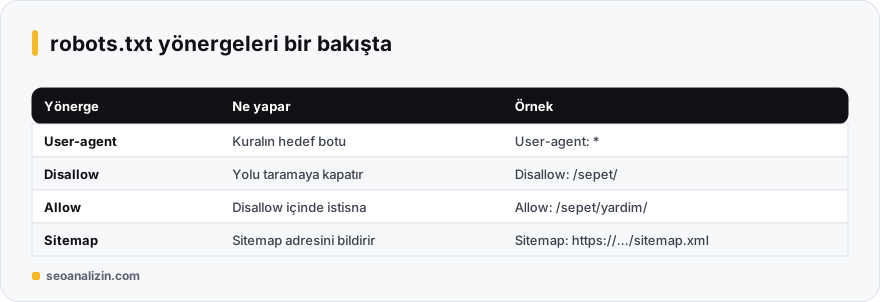
Dosyanın kuralları
- Adı tam olarak
robots.txtolmalı ve alan adının kökünde durmalı:https://ornek.com/robots.txt. - UTF-8 düz metin olmalı ve 200 durum kodu döndürmelidir. Yol adları büyük-küçük harfe duyarlıdır.
- Her alt alan adının (ve http/https ayrımının) kendi dosyası vardır.
- Google dosyanın ilk 500 KB'ını işler; daha uzunsa kalanı yok sayılır.
Temel yönergeler
User-agent: kuralın hangi bot için olduğunu belirtir;*tüm botlar demektir.Disallow: taranmasını istemediğiniz yol.Allow: bir Disallow kuralının içinde istisna tanımlar.Sitemap: sitemap adresinin tam URL'si, her yerde yazılabilir.*joker karakter,$adres sonu anlamına gelir.
Örnek: genel site
User-agent: *
Disallow: /admin/
Disallow: /sepet/
Disallow: /*?oturum=
Allow: /admin/yardim/

Sitemap: https://ornek.com/sitemap.xml
Örnek: WordPress
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://ornek.com/wp-sitemap.xml
WordPress'e özel ayrıntılar için WordPress'te robots.txt ve sitemap yazısına bakın.
Test etmek
- Dosyayı tarayıcıda açın ve düz metin olarak göründüğünü doğrulayın.
- robots.txt Testi ile önemli sayfaların engellenmediğini deneyin.
- Search Console Ayarlar > robots.txt bölümünde Google'ın dosyayı nasıl okuduğunu kontrol edin.
- Yayına almadan önce yeni kuralları geçici bir kopyada deneyin: tek bir
Disallow: /bütün siteyi tarama dışı bırakır.
Dosyayı sıfırdan yazmak istemezseniz robots.txt Oluşturucu hazır bir taslak üretir.
Sık yapılan hatalar
- CSS ve JavaScript dosyalarını engellemek: Google sayfayı doğru render edemez.
- noindex yazmak: robots.txt içindeki
Noindexyönergesini Google desteklemez. - Engellenen sayfaya noindex koymak: bot sayfayı okuyamadığı için etiketi göremez.
- Hazırlık sitesinden kalan
Disallow: /satırını yayında unutmak.
Örnek: bir e-ticaret sitesi için kural seti
Bir mağazada sepet, ödeme, hesap ve iç arama sayfaları aramada değer taşımaz; taranmaları tarama kaynağını boşa harcar. Mantıklı bir kural seti:
User-agent: *
Disallow: /sepet/
Disallow: /odeme/
Disallow: /hesabim/
Disallow: /arama?
Sitemap: https://ornek.com/sitemap.xml
Ürün, kategori ve içerik sayfalarını, ayrıca CSS ve JavaScript dosyalarını engellemeyin. Yeni kuralları yayına almadan önce robots.txt Testi ile önemli adresleri deneyin.
Kurallar çakıştığında hangisi geçerli olur?
Google, bir adres için birden fazla kural eşleşirse en uzun (en özel) yol eşleşmesini uygular. Uzunluk eşitse daha az kısıtlayıcı olan, yani Allow kazanır. Bu yüzden genel bir engelin içine dar bir izin açabilirsiniz:
User-agent: *
Disallow: /panel/
Allow: /panel/yardim/
Burada /panel/ayarlar/ kapalı, /panel/yardim/ açıktır; çünkü ikinci kural daha uzundur. Kural sırası önemli değildir, uzunluk önemlidir.
Joker karakter ve satır sonu işareti
Google iki özel karakteri destekler: * (herhangi bir karakter dizisi) ve $ (adres burada biter). Parametreli adresleri ve dosya türlerini kapatmak için işe yarar:
User-agent: *
# Arama sonuçları ve sıralama parametreleri
Disallow: /*?arama=
Disallow: /*?sirala=
# Dosya türü: .pdf ile biten adresler
Disallow: /*.pdf$
Bu satırların her biri farklı bir sorunu çözer: filtreli listeleme sayfalarının sonsuz kombinasyon üretmesini engeller ya da PDF'lerin taranmasını durdurur. Kuralı yayına almadan önce mutlaka örnek adreslerle test edin; yanlış yazılmış bir joker, istemediğiniz yüzlerce sayfayı kapatabilir.
robots.txt ile noindex aynı şey değil
En sık yapılan karışıklık budur. Disallow, Google'ın sayfayı taramasını engeller; sayfayı dizinden çıkarmaz. Başka sitelerden bağlantı alan bir adres, içeriği hiç taranmamış olsa bile sonuçlarda başlıksız bir kayıt olarak görünebilir. Dizinden çıkarmak istiyorsanız sayfaya noindex koyun ve sayfanın taranabilir kalmasını sağlayın; çünkü Google noindex'i ancak sayfayı tarayıp görürse uygular. robots.txt içine noindex yazmak ise Google tarafından 2019'dan beri desteklenmiyor. Ayrıntı için noindex rehberine bakın.
CSS ve JavaScript dosyalarını engellemeyin
Eski tavsiyelerde /wp-content/ ya da /assets/ klasörlerini kapatmak yer alır. Bugün bu zararlıdır: Google sayfayı tarayıcı gibi çizer ve stil ile betik dosyalarına erişemezse sayfanın gerçek görünümünü ve mobil uyumunu yanlış değerlendirebilir. Kapatmanız gereken yer yönetim paneli, arama sonuç sayfaları, sepet ve ödeme adımları gibi arama sonucunda işe yaramayan bölümlerdir.
Sunucu hata verirse ne olur?
- 404 ya da 410: Google dosya yok kabul eder ve her yeri taranabilir sayar.
- 5xx ya da zaman aşımı: Google bir süre siteyi tümüyle kapalıymış gibi ele alabilir ve taramayı durdurur. Dosyanın sürekli 200 dönmesi bu yüzden önemlidir.
- Yönlendirme: Aynı sitenin içinde birkaç adım takip edilir, uzun zincirler başarısız sayılır; robots.txt'yi yönlendirmeyin.
- Boyut: Google dosyanın ilk 500 KiB'ını işler; fazlası yok sayılır. Çok büyük kural listeleri yerine desenleri kullanın.
Google robots.txt'yi önbelleğe alır ve genellikle günde bir kez yeniler; değişikliğin hemen etkili olmasını beklemeyin. Search Console'daki robots.txt raporu en son alınan sürümü ve hataları gösterir.
Test sitesi robots.txt ile korunmaz
Yayına hazırlanan bir test (staging) sitesini Disallow: / ile gizlemek yeterli değildir; kural bir istektir, erişim engeli değil. Test sitelerini parola ya da IP kısıtıyla koruyun. En sık yapılan kaza ise tam tersidir: test sitesindeki Disallow: / dosyasını canlıya taşımak. Yayın günü robots.txt'yi her zaman elle kontrol edin.
Yayına almadan önce altı adımlık kontrol
- Dosya tam olarak
/robots.txtadresinde, 200 koduyla ve düz metin olarak açılıyor mu? - Her
User-agentbloğunun altında en az bir kural var mı? - Önemli sayfalarınız (ana sayfa, kategori, ürün, blog) hiçbir kuralla engelleniyor mu? Robots.txt Testi ile 5–10 örnek adresi deneyin.
- CSS, JS ve görsel klasörleri açık mı?
- Sitemap satırı tam adresle (
https://...) yazıldı mı? - Dosyayı Search Console'da gönderip hata raporunu temizlediniz mi?
robots.txt hakkında kısa cevaplar
robots.txt zorunlu mu?
Hayır. Dosya yoksa botlar her yeri tarayabilir. Yine de sitemap adresini ve gereksiz alanları belirtmek için faydalıdır.
Crawl-delay Google'da çalışır mı?
Hayır, Google bu yönergeyi dikkate almaz. Bazı diğer botlar alabilir.
Gizli içeriği robots.txt ile koruyabilir miyim?
Hayır. Dosya herkese açıktır ve yolları ifşa eder. Gizli içerik için giriş koruması kullanın.


Görüşünüzü paylaşın
Deneyiminizi, sorunuzu veya eklemek istediğiniz noktayı yazabilirsiniz.